سازمانها روزانه اطلاعات زیادی از مشتریان، قراردادها، گزارشهای مالی و فعالیتهای داخلی تولید و ذخیره میکنند. اما آیا همه این اطلاعات به یک اندازه حساس هستند؟ آیا یک کاتالوگ عمومی و اطلاعات هویتی مشتریان به سطح حفاظت یکسانی نیاز دارند؟ هر گروه از دادهها ارزش و حساسیت متفاوتی دارد. افشای برخی اطلاعات ممکن است تأثیر چندانی بر کسبوکار نداشته باشد، اما انتشار غیرمجاز دادههای مالی یا قراردادهای تجاری میتواند خسارتهای جدی ایجاد کند.
طبقهبندی داده (Data Classification) به سازمان کمک میکند اطلاعات خود را بر اساس میزان حساسیت دستهبندی کند و برای هر گروه، قواعد حفاظتی مناسبی در نظر بگیرد. در ادامه، با سطوح طبقهبندی، مراحل اجرای آن و معیارهای انتخاب ابزار مناسب آشنا میشویم.
طبقهبندی داده چیست و چرا اهمیت دارد؟
طبقهبندی داده فرایندی است که در آن سازمان میزان حساسیت اطلاعات را ارزیابی میکند و هر گروه از دادهها را در سطح امنیتی مناسبی قرار میدهد. برای مثال، یک شرکت میتواند کاتالوگ محصولات خود را در اختیار عموم قرار دهد، اما دسترسی به اطلاعات هویتی مشتریان را به کارکنان مجاز محدود کند.
مدیران و مالکان داده برای تعیین سطح حساسیت، عواملی مانند ارزش تجاری، نوع اطلاعات، الزامات قانونی، افراد مجاز و پیامدهای افشای داده را بررسی میکنند. مؤسسه ملی استاندارد و فناوری آمریکا (NIST) نیز بر استفاده از برچسبهای پایدار برای توصیف داراییهای اطلاعاتی تأکید دارد. این رویکرد به سازمانها کمک میکند الزامات امنیتی و حریم خصوصی را در مقیاس گسترده مدیریت کنند.
طبقهبندی داده تنها به شناسایی اطلاعات محرمانه محدود نیست. سازمان باید از نتیجه آن برای تنظیم سیاستهای دسترسی و حفاظت از دادهها استفاده کند. این ارتباط میان حساسیت اطلاعات و کنترلهای امنیتی، یکی از اصول رویکرد امنیت دادهمحور است.
سطوح طبقهبندی داده در سازمان
سازمانها میتوانند متناسب با نوع فعالیت و الزامات امنیتی خود، سطوح مختلفی برای طبقهبندی اطلاعات تعریف کنند. یکی از مدلهای کاربردی، تقسیم دادهها به چهار سطح است.
| سطح طبقهبندی | نمونه اطلاعات | نمونه اقدام حفاظتی |
|---|---|---|
| عمومی (Public) | کاتالوگ محصولات و محتوای وبسایت | اجازه انتشار عمومی |
| داخلی (Internal) | دستورالعملها و گزارشهای عملیاتی | محدودکردن دسترسی به کارکنان مجاز |
| محرمانه (Confidential) | قراردادها و اطلاعات مشتریان | کنترل دسترسی و انتقال اطلاعات |
| بسیار محرمانه (Highly Confidential) | اسرار تجاری و کلیدهای حساس | محدودیت شدید دسترسی و رمزنگاری متناسب |
این مدل یک نمونه است و سازمان باید قواعد هر سطح را متناسب با حساسیت واقعی اطلاعات و الزامات خود تعیین کند.
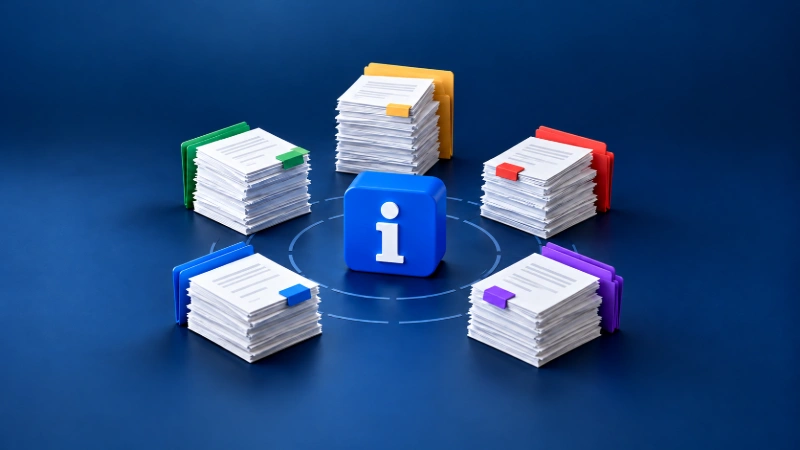
سازمانها میتوانند طبقهبندی داده را در پنج مرحله اجرا کنند. هر مرحله باید خروجی مشخصی داشته باشد تا تیم امنیت بتواند نتیجه آن را در مرحله بعد به کار بگیرد.
۱. شناسایی و فهرستبرداری از دادهها
تیم IT ابتدا باید محل نگهداری اطلاعات را مشخص کند. منابع اصلی شامل File Server، پایگاههای داده، ایمیل، SharePoint، سرویسهای ابری، نرمافزارهای SaaS و سیستمهای کاربران هستند. برای مثال، ممکن است واحد فروش اطلاعات مشتریان را در پایگاه داده نگهداری کند و نسخههایی از همان اطلاعات را از طریق ایمیل به سایر واحدها ارسال کند. تیم امنیت باید هر دو محل و مسیر انتقال اطلاعات را شناسایی کند.
خروجی این مرحله: فهرست منابع اطلاعاتی، محل نگهداری دادهها و مسیرهای اصلی تبادل آنها.
۲. تعیین مالک و مسئول دادهها
سازمان باید برای هر گروه از اطلاعات، فرد یا واحد مسئول تعیین کند. مالک داده درباره سطح حساسیت، افراد مجاز و شرایط استفاده از اطلاعات تصمیم میگیرد. برای مثال، واحد فروش میتواند مسئولیت تعیین حساسیت اطلاعات مشتریان را بر عهده بگیرد. تیم امنیت نیز بر اساس این تصمیمها، الزامات حفاظتی مناسب را طراحی میکند.
خروجی این مرحله: مشخصشدن مالک هر گروه از دادهها و مسئولیت او در تصمیمگیری درباره سطح حساسیت اطلاعات.
۳. تعریف سیاستها و سطوح طبقهبندی
مالکان داده و تیم امنیت باید معیارهای حساسیت را به قواعد اجرایی تبدیل کنند. این قواعد باید محدوده دسترسی، شرایط اشتراکگذاری، دانلود، رمزنگاری، نگهداری و انتقال اطلاعات را مشخص کنند. برای مثال، سازمان میتواند فقط به کارکنان مجاز واحد فروش اجازه مشاهده اطلاعات محرمانه مشتریان را بدهد و انتقال آنها به خارج از سازمان را محدود کند.
خروجی این مرحله: ماتریس طبقهبندی داده که سطوح حساسیت، افراد مجاز و کنترلهای حفاظتی هر سطح را مشخص میکند.
۴. برچسبگذاری و اجرای کنترلهای حفاظتی
پس از تعیین سیاستها، کاربران یا ابزارهای طبقهبندی باید برچسب مناسب را به اطلاعات اختصاص دهند.
برای مثال، اگر مالک داده اطلاعات هویتی مشتریان را محرمانه تشخیص دهد، تیم امنیت میتواند متناسب با این سطح، دسترسی به فایلها را محدود کند. همچنین سازمان میتواند از نتیجه طبقهبندی بهعنوان یکی از معیارهای سیاستهای DLP استفاده کند. در این صورت، راهکار DLP میتواند متناسب با قابلیتهای خود، انتقال غیرمجاز اطلاعات حساس به ایمیل شخصی یا سایر مقصدهای غیرمجاز را شناسایی یا مسدود کند.
خروجی این مرحله: اطلاعات دارای برچسب مناسب و سیاستهای حفاظتی که بر اساس حساسیت دادهها عمل میکنند.
۵. بازبینی و بهروزرسانی طبقهبندیها
حساسیت اطلاعات ممکن است در طول زمان تغییر کند. برای مثال، سازمان میتواند پس از انتشار عمومی یک پروژه، سطح محرمانگی برخی اسناد آن را کاهش دهد. در مقابل، اضافهکردن اطلاعات مالی یا هویتی به یک فایل داخلی ممکن است نیاز به حفاظت بیشتری ایجاد کند. مالکان داده باید طبقهبندیها را در دورههای مشخص بررسی کنند و هنگام تغییر محتوا، مالکیت یا الزامات کسبوکار، برچسبها و سیاستهای حفاظتی را اصلاح کنند.
خروجی این مرحله: برنامه بازبینی دورهای، اصلاح برچسبهای نامتناسب و بهروزرسانی سیاستهای امنیتی. سازمان در طول این فرایند باید از طبقهبندی بیشازحد یا کمتر از حساسیت واقعی اطلاعات جلوگیری کند؛ زیرا هر دو خطا میتوانند کارایی کنترلهای امنیتی را کاهش دهند.
طبقهبندی دستی و خودکار داده چه تفاوتی دارند؟
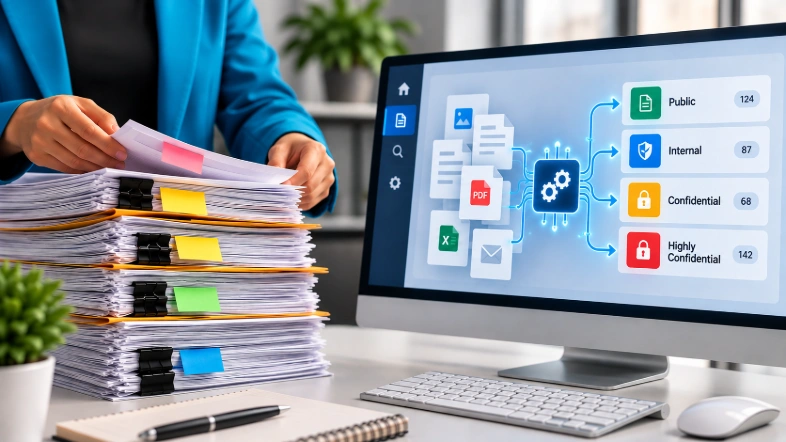
در طبقهبندی دستی، کاربر یا مالک داده محتوای اطلاعات را بررسی میکند و سطح حساسیت مناسب را انتخاب میکند. این روش برای دادههایی کاربرد دارد که تشخیص ارزش آنها به شناخت کسبوکار نیاز دارد.
در طبقهبندی خودکار، نرمافزار با تحلیل محتوا، الگوها و انواع اطلاعات حساس، برچسب مناسب را پیشنهاد میدهد یا اعمال میکند. برای مثال، Microsoft Purview از قابلیتهایی مانند Pattern Matching و Trainable Classifiers برای شناسایی محتوا بهره میبرد و در برخی سناریوها امکان اعمال خودکار برچسب را فراهم میکند.
سازمانهای بزرگ معمولاً میتوانند از ترکیب این دو روش نتیجه بهتری بگیرند؛ ابزارهای خودکار حجم بالایی از اطلاعات را بررسی میکنند و کارشناسان انسانی درباره موارد پیچیده تصمیم میگیرند.
چگونه ابزار مناسب طبقهبندی داده را انتخاب کنیم؟
سازمان باید ابزار طبقهبندی را بر اساس نوع اطلاعات، زیرساخت و الزامات امنیتی خود انتخاب کند. هنگام ارزیابی راهکارهای مختلف، پنج معیار اهمیت بیشتری دارند:
- پوشش منابع اطلاعاتی: آیا ابزار میتواند منابع اصلی سازمان، مانند File Server، پایگاههای داده، ایمیل و محیطهای On-Premise، Cloud یا Hybrid را بررسی کند؟
- دقت شناسایی اطلاعات حساس: آیا ابزار از دادههای ساختاریافته و بدون ساختار پشتیبانی میکند و چه میزان False Positive و False Negative دارد؟
- قابلیت طبقهبندی: آیا امکان برچسبگذاری دستی، خودکار و تعریف سیاستهای سفارشی را فراهم میکند؟
- یکپارچگی با کنترلهای امنیتی: آیا سازمان میتواند نتایج طبقهبندی را در سیاستهای DLP و راهکارهای مدیریت دسترسی به کار بگیرد؟
- گزارشگیری و بازبینی: آیا ابزار امکانات مناسبی برای بررسی نتایج و اصلاح طبقهبندیها ارائه میدهد؟
تیم امنیت باید پیش از انتخاب نهایی، عملکرد ابزار را با دادههای واقعی سازمان آزمایش کند. این بررسی به کارشناسان کمک میکند محدودیتهای راهکار را بشناسند و درباره تناسب آن با نیازهای امنیتی تصمیم بگیرند.
جمعبندی؛ طبقهبندی داده را از کجا آغاز کنیم؟
اجرای طبقهبندی داده از شناخت داراییهای اطلاعاتی آغاز میشود، نه انتخاب نرمافزار. سازمان باید ابتدا دادههای حساس و مالکان آنها را مشخص کند، سپس سیاستهای حفاظتی متناسب با هر سطح را طراحی کند. در سازمانهایی که اطلاعات را در منابع مختلف نگهداری میکنند، ابزارهای شناسایی و طبقهبندی داده میتوانند اجرای این فرایند را سادهتر کنند. بااینحال، انتخاب راهکار باید با نیازهای زیرساختی و سیاستهای امنیتی سازمان هماهنگ باشد.
اگر قصد دارید وضعیت طبقهبندی و حفاظت از اطلاعات سازمان خود را ارزیابی کنید، کارشناسان رادسکیور میتوانند در بررسی نیازها و انتخاب راهکار مناسب همراه شما باشند. برای دریافت مشاوره تخصصی با رادسکیور تماس بگیرید.


